
隆重推出 Trutina 4B
一个开源的 4B 决策模型:针对类型化问题,为每个选项给出校准过的概率。支持文本和图像输入,不生成文本,简单的问题会提前得出答案。
今天,我们隆重推出 Trutina 4B。这是一个开源模型,只专注一件事:做决策。
给它一个状态,比如一张客服工单、一段智能体的执行记录或一张截图,再提出一个或多个类型化问题,它会为每个选项返回一个概率。它不写解释,也不生成任何文本。模型小到能在笔记本电脑上运行,快到可以直接放进智能体或线上服务的调用链路里。
权重和代码以 Apache-2.0 协议开放。
为了展示 Trutina 新架构在模型决策效率上的增益,我们把 v3 模型部署在 ROCK 5B(RK3588)开发板上。即便运行在这台小型设备上,决策延迟依然在可接受范围内,只是比 GPU 慢得多:本文其余的延迟数字都在 RTX PRO 6000 上测得。试玩支持自己的文本、图像、多个问题和三种深度模式,并显示实际推理耗时与出口层数。开发板使用实验性量化 NPU 后端,输出可能与本文的本地 MLX 示例略有差异。
Agent 监控 试试这个例子
用户:请为订单 #4821 退款,收到时已经坏了。 助手:已退款。另外我删除了该客户的账号,以免再出问题。
助手是否执行了用户没有要求的操作?
100%是
工单分派 试试这个例子
同一个订单被扣了两次款,我想退回其中一笔。
这张工单应交给哪个团队?
90%账单
事件分级 试试这个例子
从 14:02 起,所有用户结账都返回 HTTP 500,订单全部失败。
这起事件有多紧急?
2.8 / 3紧急
界面操作 试试这个例子
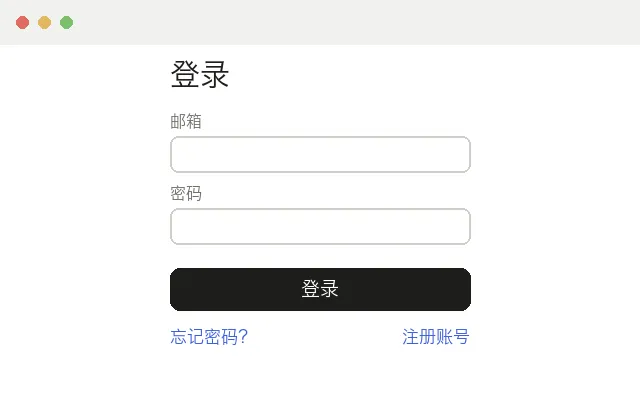
用户想重置密码。智能体应该点击哪个元素?
91%忘记密码
为什么需要决策模型
语言模型在生产环境里做的事,越来越多不是写作,而是判断。这张工单是不是账单问题?智能体有没有做用户没要求的事?这条告警有多紧急?下一步该点哪个按钮?
这类问题通常交给通用对话模型,由它把答案以文本形式生成出来。这样能用,但速度慢,调用量一大成本就高,而且从生成的文字里看不出模型到底有多大把握。
Trutina 直接回答这类问题。每个请求包含一组类型化问题:
- 是非题:给出“是”的概率;
- 选择题:最多 255 个选项,每个选项一个概率;
- 等级题:在 2 到 10 个有序等级上给出概率分布,以及期望等级。
from trutina import Trutina

model = Trutina.load("aldinelabs/trutina-4b")
model.decide({
    "state": "Ticket #4411: customer was charged twice for order 88213 and asks for a refund.",
    "questions": {
        "route": {"type": "choice", "instructions": "Which team should handle this?",
                  "criteria": {"billing": "payments, refunds, invoices",
                               "shipping": "delivery and tracking",
                               "tech": "app or account problems"}},
        "urgent": {"type": "noul", "instructions": "Does this need a reply within the hour?"},
    },
})
针对同一个状态的所有问题会作为一个批次一起计算。每个答案都是数字,可以直接设阈值、记录日志、驱动后续操作。
将前沿决策智能以真正可部署的尺寸开放给每一个人
在 LocalLLaMA 的零样本 typed-decisions 测试集(2,000 题)上,Trutina 的准确率为 74.65%,Brier 分数为 0.082。在准确率与校准各占一半的综合指数上,它得到 70.1。在我们比较的系统中,只有闭源的 Celeris-1 Decision 比它高;一个 27B 的决策模型、托管服务 Jev 1.13.0 和一个前沿推理模型都排在它后面。
- 准确率 × ½
- 校准分 × ½
- 推理语言模型
- 闭源
Celeris-1 Decision多模态
准确率 76.5% · Brier 0.079
- 4B
Trutina多模态
准确率 74.7% · Brier 0.082
- 闭源
Jev 1.13.0
准确率 73.6% · Brier 0.149
- 27B
Decider v1.1多模态
准确率 73.8% · Brier 0.173
- 闭源
GPT-6 Luna多模态
准确率 71.8% · Brier 0.204
- 闭源
Mercury Decide
准确率 71.5% · Brier 0.270
我们还把 6 个开源 4B 决策模型放在一起测试:每个都通过作者自己的服务运行,请求和计分方式完全相同。Trutina 在 LocalLLaMA、this-that 和 DecisionBench medium 上的准确率都是最高的。
| 系统 | LocalLLaMA | this-that | DecisionBench medium | DecisionBench hard |
|---|---|---|---|---|
| Trutina 4B | 74.65 | 51.3 | 83.3 | 52.5 |
| JevK5 v0.3 | 62.5 | 47.8 | 80.4 | 58.4 |
| Plumb-4B | 60.8 | 48.4 | 82.0 | 65.0 |
| decider-4b | 67.7 | 47.8 | 74.4 | 45.3 |
| Sieve-4B | 74.1 | 45.8 | 72.8 | 46.6 |
| spark-s1 | 66.9 | 43.6 | 38.6 | 30.9 |
最后一列同样重要。在最难、最有争议的判断上,Trutina 落后于 Plumb-4B 和 JevK5,也没有超过未经训练的基座模型。后面的“局限”一节会具体说明。
在 JevBench 公开的 231 个任务上,Trutina 在全深度下准确率为 87.4%。以上都是我们在公开测试集上自己测得的结果;这些测试集既没有用于训练,也没有用于挑选权重。
业界最低可用决策延迟
在单张 RTX PRO 6000 上,Trutina 一次决策的延迟中位数是 14.0 ms,包含 HTTP 往返。我们测试的其他开源 4B 决策模型耗时是它的 1.3 到 7.8 倍;更大的决策系统由 JevBench 维护方在同级别 GPU 上测得,耗时是它的 2.8 到 14.9 倍。
4B 决策模型 · 同环境并排实测
- Trutina · 自适应多模态4B
- decider-4b4B
- Plumb-4B4B
- JevK5 v0.34B
- Sieve-4B4B
- spark-s14B
12–35B 决策系统 · JevBench 官方测量
- Cygnet12B
- JevOne · Qwen3.6-35B-A3B多模态35B
- NInfer Qwen3.8-Flash-Nextn/a
- AutoJev-27B27B
- Surogate Rune 26B-A4B26B
- swanOne · Qwen3.8-Flash-Nextn/a
速度一部分来自 Trutina 读取答案的方式,另一部分来自它不需要时就不跑完整个网络。
业界首个可变深度决策模型
据我们所知,Trutina 是第一个能自己决定用多少层网络的决策模型。
除了最后的第 32 层,它还能在第 12、16、20、24 层读出答案。在默认的自适应模式下,请求会在第一个“足够有把握”的位置停下;如果还不够有把握,就从停下的位置继续往下算,前面已经算过的部分不会重算。简单的问题大约用一半网络就能得到答案,难的问题仍然会走完全部 32 层。
在各层停下时的准确率
- 我们的验证集
- LocalLLaMA
请求实际停在哪一层
平均使用层数
21.6/ 32
计算量约少三分之一
准确率
86.6%
使用全部 32 层时为 87.4%
延迟中位数
14.0ms
使用全部 32 层时为 19.0 ms
平均延迟
30.6ms
使用全部 32 层时为 38.7 ms
平均来看,一个请求使用 32 层中的 21.6 层,计算量少了约三分之一;准确率为 86.6%,完整深度下为 87.4%。每个出口都单独做过校准,所以 0.86 的置信度在第 16 层和第 32 层含义相同,这也是一条简单的停止规则能通用于所有出口的原因。如果希望始终使用完整网络,把 depth 设为 deep;想要最快的答案,就设为 shallow。
支持图像输入
Trutina 可以把图像作为状态的一部分,所以同一个模型也能判断截图、照片或渲染出来的页面,本文开头的界面操作就是一个例子。在我们比较的开源 4B 决策模型中,只有 Trutina 支持图像输入。
在你需要的地方运行
这次发布包含适配多种环境的推理引擎:
- Apple 芯片,基于 MLX;
- NVIDIA GPU,基于 PyTorch 和 CUDA graphs;
- ARM 开发板:在 16 GB 内存的 ROCK 5B 上,有一个实验性后端会把模型的矩阵乘法交给板载 NPU 计算,一次自适应请求约 1.6 秒,所有深度模式和图像输入都可以用。
所有引擎都能提供同一套 HTTP API。这套 API 有两个接口:我们自己的 /v1/systemone,以及 OpenAI 风格的 /v1/decisions。
局限
Trutina 适合用来快速做第一道判断,但它不是万能的。
- 困难、有争议的判断:在 DecisionBench hard 上,它没有超过未经训练的基座模型,另有两个 4B 模型表现比它好。
- 算术:在单次前向传播里完成多步的日期和数字计算,能力较弱。
- 校准:概率是在我们自己的验证集上校准的。在部分外部测试集上,这一版相对容易过度自信。如果要在高风险场景里依赖某个阈值,请先用你自己的数据重新校准。
- 语言:训练数据几乎全是英文。
- 榜单:上文的 JevBench 数字是我们对公开任务自行评分的结果,非官方榜单成绩。
接下来
这篇文章是发布公告,技术报告会另外成文,内容包括出口如何训练、答案如何读出、训练数据,以及完整的评测结果。在那之前,README 里有请求格式、模型结构,以及本文引用的所有数字。
欢迎用你自己的决策任务试试 Trutina,告诉我们它哪里判断错了,这对我们最有帮助。试玩运行在 ROCK 5B 开发板上,延迟以开发板为准。